目前处于待完善的状态。
多态#
多态的定义:同一个调用,作用在不同对象上,表现不同。
interface Animal { void speak(); }

class Dog implements Animal {
    public void speak() { System.out.println("汪"); }
}
class Cat implements Animal {
    public void speak() { System.out.println("喵"); }
}

public class Demo {
    public static void talk(Animal a) {
        a.speak();
    }
    public static void main(String[] args) throws Exception {
		// 多态的体现位置:同一个调用 talk(), 但作用的对象分别是 Dog 和 Cat,所表现的行为也不同
        talk(new Dog());
        talk(new Cat());
    }
}
输出:
汪
喵
针对 talk 的参数,编译器只会检查 Animal 有没有 speak() 方法。到底执行 Dog 的还是 Cat 的,要等运行时看传进来的是什么对象来决定。
从面向对象的视角看,这是“多态”的体现;从编译器和虚拟机的视角看,这是“动态分派(Dynamic Dispatch)”的体现
Java 中的任意一个类,都会继承 Object 类。你可以在 IDEA 中选中任意一个类,然后按 Ctrl + H,就能看到层级关系:
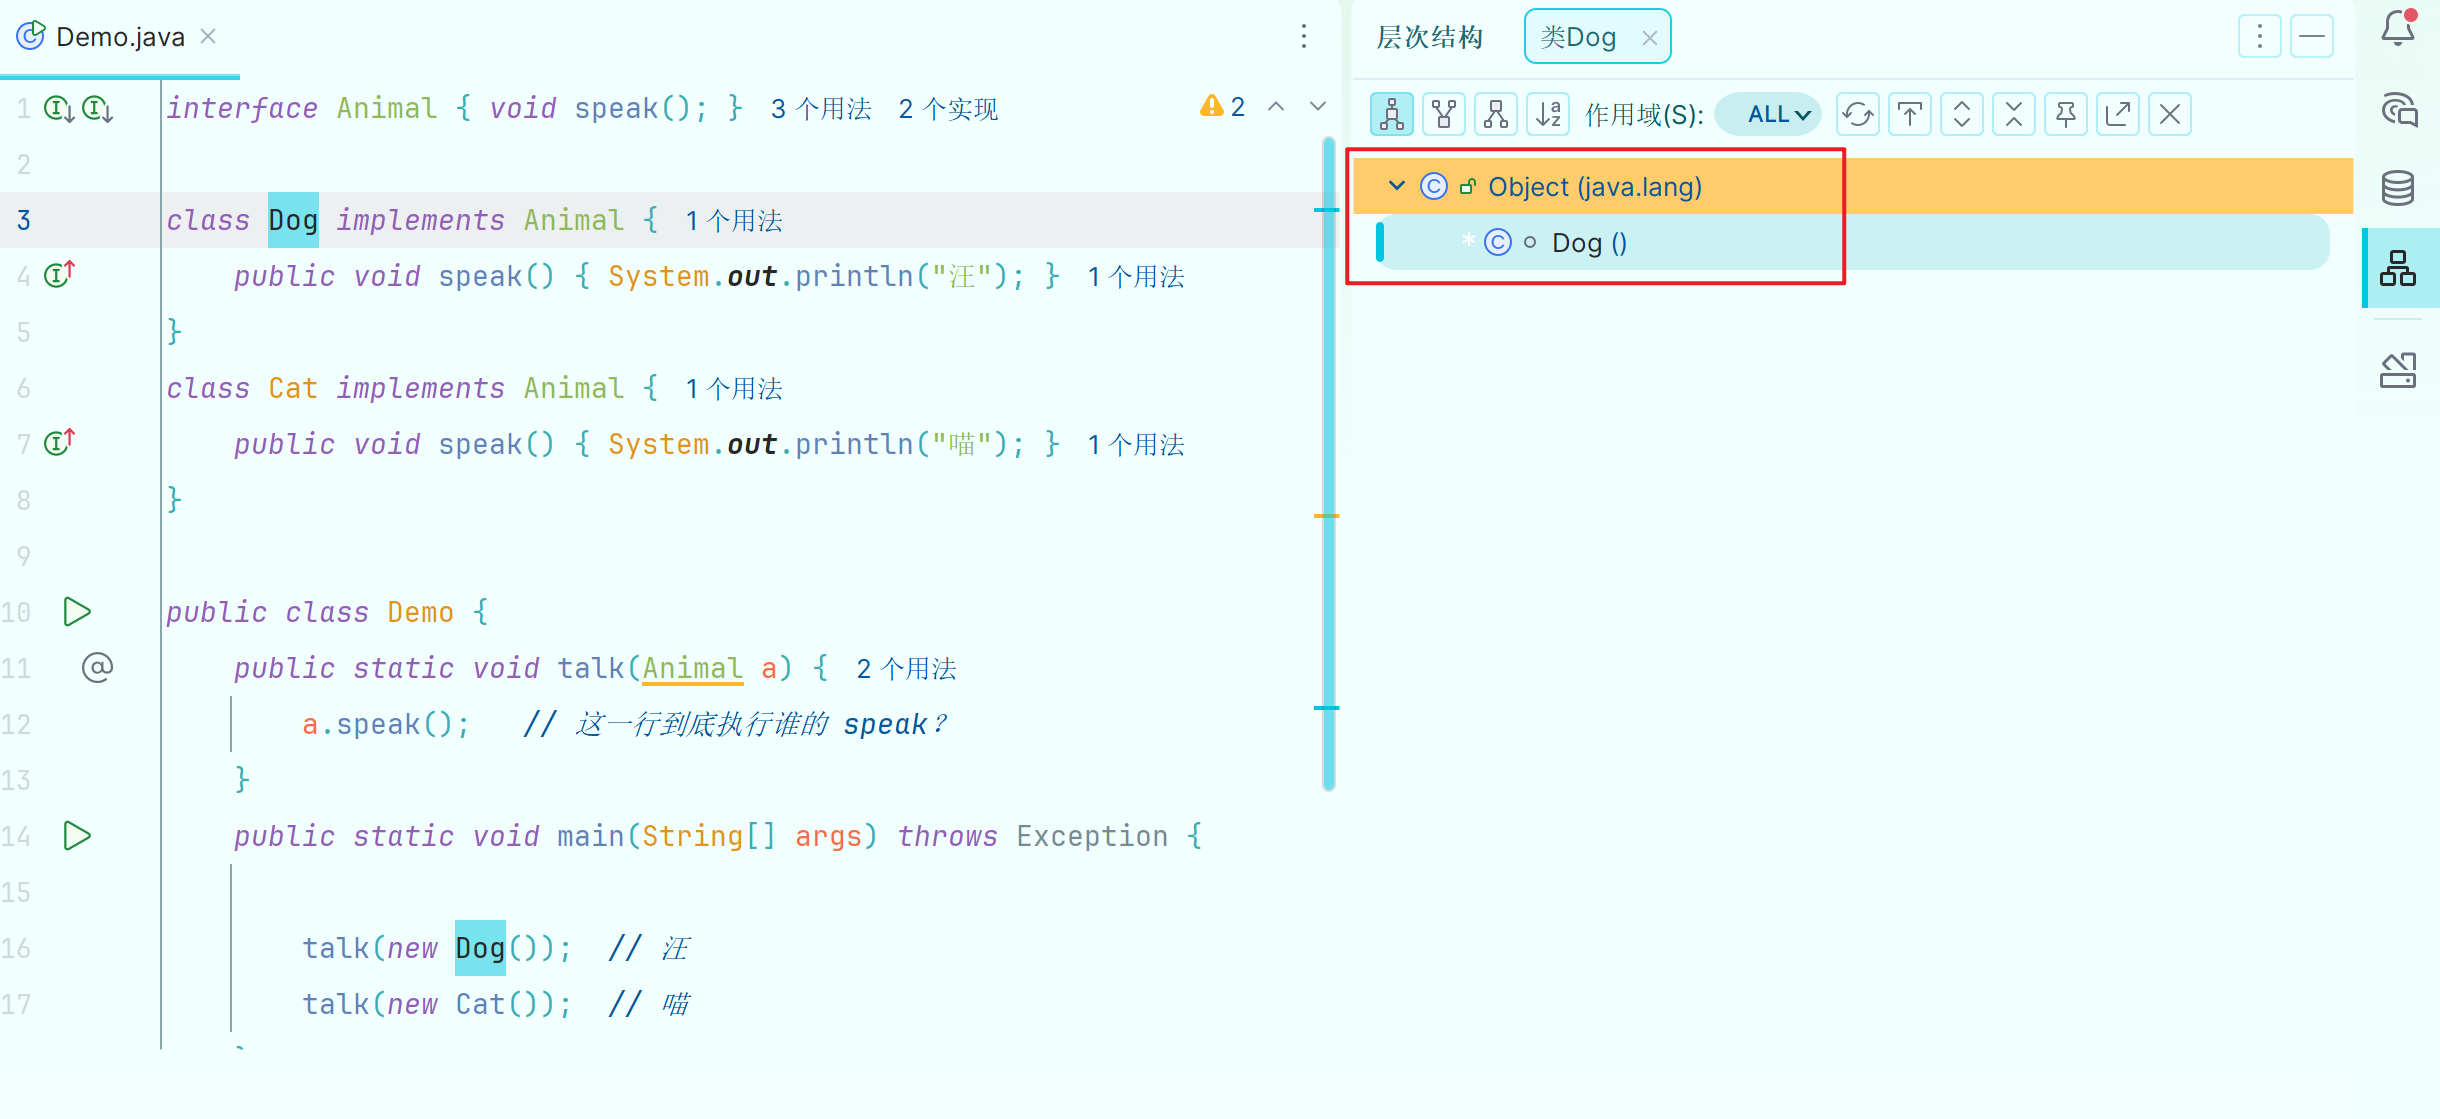
因此,Object 中的方法如果同时满足:
- 不是
private - 不是
final - 不是
static
则这些方法可以被任何任何类重写。
满足条件的方法:
hashCode()equals()toString()
结合上面讲的“多态”,可以得到一个结论:调用 Object 的 hashCode(),实际跑的可能是任何一个类重写的 hashCode()。
集合会“自动”调用你对象的方法#
HashMap 是 Java 集合框架(java.util 包)中最常用的数据结构之一:
Map<String, Integer> scores = new HashMap<>();
// 存入键值对到哈希表
scores.put("Alice", 95);
map.put(k, v) 看起来只是存东西,其实 HashMap 内部会主动调用 k 的一些方法。
举个例子:
class Key {
    int id;
    Key(int id) { this.id = id; }

    @Override public int hashCode() {
        System.out.println("hashCode 被调用, id=" + id);
        return id % 2;
    }
    @Override public boolean equals(Object o) {
        System.out.println("equals 被调用, id=" + id);
        return o instanceof Key k && k.id == id;
    }
}

Map<Key, String> m = new HashMap<>();
m.put(new Key(1), "a");
m.put(new Key(3), "b");
输出:
hashCode 被调用, id=1
hashCode 被调用, id=3
equals 被调用, id=3
原因:
- 每次
put,HashMap 都会先调k的hashCode()方法来算出该放进哪个桶 - 由于
hashCode()被重写,1 % 2和3 % 2都等于 1,两个 key 进了同一个桶,HashMap 必须调equals()判断它们是不是同一个 key
这里其实还用到了多态,HashMap 的源码虽然是固定的,但它内部调用的 hashCode()、equals() 跑的却是放进去的那个对象自己的实现。
反射#
反射的定义:Java 程序在运行时可以查看并操作类的结构(比如有哪些字段、方法、构造器)。
换言之,有了反射,在编写、编译的阶段,甚至可以不用定义类,就能写好处理该类的一系列逻辑。但是在运行的时候,JVM 就必须要找到对应类的定义。
普通写法要求编译时就确定用哪个类、类的哪个方法:
class User{
    public String name;
    public void setName(String name){
        this.name = name;
        System.out.println("你的名字是:" + this.name);
    }
}

public class Demo {
    public static void main(String[] args) throws Exception {
        User u = new User();
        u.setName("Tom");
    }
}
用反射时,类名和方法名可以是运行时才拿到的字符串:
Class<?> clazz = Class.forName("com.example.User");
Object u = clazz.getDeclaredConstructor().newInstance();
Method m = clazz.getMethod("setName", String.class);
m.invoke(u, "Tom"); 不难发现,编写代码时,你可以先不定义对应的类以及里面的属性、方法,只需要写好处理该类的对应逻辑。但是在最终运行时,无论是调用库,还是你自己写,都需要让 JVM 能找到 User 类的定义。
反射的价值主要体现在框架里,因为在写框架的时候,根本不知道将来使用框架的程序员会写什么类。但是在反序列化漏洞中,该机制通常用于:
- 突破访问修饰符的限制,拿到类、属性、方法等
- ……(待续)
动态代理#
动态代理的定义:在运行时自动生成一个“替身”对象(动态代理对象),所有对它的方法的调用都会被拦下来,交给你写的一段统一的逻辑(处理器)来处理。
假设有一个 UserService 接口,他实现的核心逻辑就是“保存用户”:
public interface UserService {
    void saveUser(String name);
}

public class UserServiceImpl implements UserService {
    @Override
    public void saveUser(String name) {
        System.out.println("保存用户: " + name);
    }
}
如果你想给核心逻辑添加日志信息,最直接的方式就是实现一个代理类(类似 Python 中的装饰器的用法):
// 静态代理类
public class UserServiceProxy implements UserService {
    private final UserService target;

    public UserServiceProxy(UserService target) {
        this.target = target;
    }

    @Override
    public void saveUser(String name) {
        System.out.println("[日志] 开始执行...");
        target.saveUser(name);
        System.out.println("[日志] 执行结束...");
    }
}这被称为静态代理。因为一旦接口切换,你就得重新写一遍一样的代理类逻辑。
JDK 动态代理则不同:
import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.lang.reflect.Proxy;

// 定义接口
interface UserService {
    void saveUser(String username);
}

// 目标类(实现接口)
class UserServiceImpl implements UserService {
    @Override
    public void saveUser(String username) {
        System.out.println("核心业务:保存用户 -> " + username);
    }
}

// 实现调用处理器(定义增强逻辑)
class LogInvocationHandler implements InvocationHandler {
    private final Object target; // 持有真实目标对象的引用

    public LogInvocationHandler(Object target) {
        this.target = target;
    }

    @Override
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        System.out.println("[前置日志] 准备执行方法: " + method.getName());

        // 通过反射调用真实目标对象的方法
        Object result = method.invoke(target, args);

        System.out.println("[后置日志] 方法执行完毕: " + method.getName());
        return result;
    }
}

// 测试生成代理对象
public class JdkProxyDemo {
    public static void main(String[] args) {
        UserService target = new UserServiceImpl();

        // 动态生成代理对象
        UserService proxy = (UserService) Proxy.newProxyInstance(
                target.getClass().getClassLoader(), // 类加载器
                target.getClass().getInterfaces(),  // 目标类实现的接口数组
                new LogInvocationHandler(target)    // 拦截处理器
        );

        // 调用代理对象的方法(实际上会触发 invoke 方法)
        proxy.saveUser("Alice");
    }
}输出:
[前置日志] 准备执行方法: saveUser
核心业务:保存用户 -> Alice
[后置日志] 方法执行完毕: saveUser
其中的:
UserService proxy = (UserService) Proxy.newProxyInstance(
		target.getClass().getClassLoader(), // 类加载器
		target.getClass().getInterfaces(),  // 目标类实现的接口数组
		new LogInvocationHandler(target)    // 拦截处理器
);
会在运行时动态生成一个代理对象,通常名为 $Proxy0。这个只出现在内存中,但是可以通过添加下述代码来记录这个动态生成的对象(JDK 8 及其之前版本):
System.getProperties().put("sun.misc.ProxyGenerator.saveGeneratedFiles", "true");
UserService proxy……
如果是 JDK 9 及其之后版本:
System.getProperties().put("jdk.proxy.ProxyGenerator.saveGeneratedFiles", "true");
UserService proxy……
代码运行后,会生成一个 $Proxy0.class 文件,这就是动态生成的代理对象,其内容大致(IDEA 的反编译):
import java.lang.invoke.MethodHandles;
import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.lang.reflect.Proxy;
import java.lang.reflect.UndeclaredThrowableException;

final class $Proxy0 extends Proxy implements UserService {
    private static final Method m0;
    private static final Method m1;
    private static final Method m2;
    private static final Method m3;

    public $Proxy0(InvocationHandler var1) {
        super(var1);
    }

    public final int hashCode() {
        try {
            return (Integer)super.h.invoke(this, m0, (Object[])null);
        } catch (RuntimeException | Error var2) {
            throw var2;
        } catch (Throwable var3) {
            throw new UndeclaredThrowableException(var3);
        }
    }

    public final boolean equals(Object var1) {
        try {
            return (Boolean)super.h.invoke(this, m1, new Object[]{var1});
        } catch (RuntimeException | Error var2) {
            throw var2;
        } catch (Throwable var3) {
            throw new UndeclaredThrowableException(var3);
        }
    }

    public final String toString() {
        try {
            return (String)super.h.invoke(this, m2, (Object[])null);
        } catch (RuntimeException | Error var2) {
            throw var2;
        } catch (Throwable var3) {
            throw new UndeclaredThrowableException(var3);
        }
    }

    public final void saveUser(String var1) {
        try {
            super.h.invoke(this, m3, new Object[]{var1});
        } catch (RuntimeException | Error var2) {
            throw var2;
        } catch (Throwable var3) {
            throw new UndeclaredThrowableException(var3);
        }
    }

    static {
        ClassLoader var0 = $Proxy0.class.getClassLoader();

        try {
            m0 = Class.forName("java.lang.Object", false, var0).getMethod("hashCode");
            m1 = Class.forName("java.lang.Object", false, var0).getMethod("equals", Class.forName("java.lang.Object", false, var0));
            m2 = Class.forName("java.lang.Object", false, var0).getMethod("toString");
            m3 = Class.forName("UserService", false, var0).getMethod("saveUser", Class.forName("java.lang.String", false, var0));
        } catch (NoSuchMethodException var2) {
            throw new NoSuchMethodError(((Throwable)var2).getMessage());
        } catch (ClassNotFoundException var3) {
            throw new NoClassDefFoundError(((Throwable)var3).getMessage());
        }
    }

    private static MethodHandles.Lookup proxyClassLookup(MethodHandles.Lookup var0) throws IllegalAccessException {
        if (var0.lookupClass() == Proxy.class && var0.hasFullPrivilegeAccess()) {
            return MethodHandles.lookup();
        } else {
            throw new IllegalAccessException(var0.toString());
        }
    }
}从代码中可见,$Proxy0 的父类是 Proxy,因此代码中的 super 指代的都是 Proxy。
代码的开头有这么一段:
public $Proxy0(InvocationHandler var1) {
	super(var1);
}
这会调用 Proxy 的含参数的构造方法,即:
protected Proxy(InvocationHandler h) {
	Objects.requireNonNull(h);
	this.h = h;
}
传入的 var1 对应着 Proxy.newProxyInstance 的第三个参数,即处理器对象。
因此(重要结论),后续代码中的 super.h 指代的都是处理器对象。而且你能发现,代理对象中的所有方法本质上都是在调用 super.h.invoke,这也是为什么处理器的处理逻辑都写在其 invoke 方法中。
序列化与反序列化#
关于序列化与反序列化的定义,这里不再介绍,详见这篇笔记。
在 Java 原生序列化中,Java 对象经过序列化之后会变成一串二进制字节流:
import java.io.ObjectOutputStream;
import java.io.FileOutputStream;
import java.io.Serializable;

class User implements Serializable {
    String name = "";
    User(String name){
        System.out.println("构造方法调用");
        this.name = name;
    }
}

public class Demo{
    public static void main(String args[]) throws Exception{
        FileOutputStream fos = new FileOutputStream("name.ser");
        ObjectOutputStream os = new ObjectOutputStream(fos);
        os.writeObject(new User("Bob"));
        os.close();
    }
}
编译 → 运行,会得到一个 name.ser 文件,里面存储的就是 User 的实例对象序列化后的结果:
PS D:\java_project\test\test-serialize\src> xxd ..\name.ser
00000000: aced 0005 7372 0004 5573 6572 372e 4b3e  ....sr..User7.K>
00000010: 0551 4558 0200 014c 0004 6e61 6d65 7400  .QEX...L..namet.
00000020: 124c 6a61 7661 2f6c 616e 672f 5374 7269  .Ljava/lang/Stri
00000030: 6e67 3b78 7074 0003 426f 62              ng;xpt..Bob
开头总是 AC ED 这个魔数头,后面的两字节 00 05 表示协议版本号。
反序列化:
import java.io.*;

class User implements Serializable {
    String name = "";
    User(String name){
        System.out.println("构造方法被调用");
        this.name = name;
    }
}

public class Demo{
    public static void main(String args[]) throws Exception{
        FileOutputStream fos = new FileOutputStream("name.ser");
        ObjectOutputStream os = new ObjectOutputStream(fos);
        os.writeObject(new User("Bob"));
        os.close();

        FileInputStream fis = new FileInputStream("name.ser");
        ObjectInputStream ois = new ObjectInputStream(fis);
        User u = (User)ois.readObject();
        System.out.println(u.name);
    }
}
输出:
构造方法被调用
Bob
不难发现,“构造方法被调用”这句话是在:
new User("Bob")的时候调用了构造方法从而打印出来的。而反序列化,虽然是一个从二进制字节流转变成对象的过程(类似于创建了一个对象),但是其中并不涉及到该对象构造方法的调用,因此“构造方法被调用”这句话仅输出了一次。
构造方法往往会给一些属性赋值,而在序列化的时候,这些属性大多会被写入到二进制字节流中,反序列化的时候,JVM 会根据这些二进制字节流来恢复对象。“恢复”这一过程的本质与构造方法所作的事情类似,如果再执行一遍构造方法,反而会多此一举。
再来看一个例子:
import java.io.*;

class Animal {
    Animal() { System.out.println("Animal 构造"); }
}

class Dog extends Animal implements Serializable {
    String name = "默认名";
    Dog(String name) { System.out.println("Dog 构造"); this.name = name; }
}

public class Demo {
    public static void main(String[] args) throws Exception {
        ByteArrayOutputStream bos = new ByteArrayOutputStream();
        new ObjectOutputStream(bos).writeObject(new Dog("旺财"));

        ObjectInputStream in = new ObjectInputStream(new ByteArrayInputStream(bos.toByteArray()));
        Dog d = (Dog) in.readObject();
        System.out.println(d.name);
    }
}
输出:
Animal 构造
Dog 构造
Animal 构造
旺财
反序列化恢复 Dog 对象的时候,虽然没有调用 Dog 的构造方法,但是调用了其父类的构造方法,因此出现了两次“Animal 构造”。
这其实有一个准确的规则的,即从子类开始往上找,找到第一个没有实现 Serializable 接口的父类,只执行它的无参构造方法(以及它往上的部分),这个类以下的构造逻辑全部跳过。
如果找到的第一个没有实现 Serializable 接口的父类并没有无参构造方法,则会报错。
按上例走一遍,Dog 往上开始找,找到第一个没有实现 Serializable 接口的父类即 Animal,以此类为分界线:
- 此类的子类、孙类……的构造方法均不执行
- 此类、此类的父类、爷类的无参数构造方法均执行
深度优先#
Java 原生序列化与反序列化都采用深度优先,对于下述结构:
class A { B b; C c; }
class B { D d; }
序列化和反序列化的顺序都是 A → B → D → C,而不是广度优先的 A → B → C → D。
readObject#
被反序列化的对象中如果实现了 readObject 方法,而且实现需要完全符合下述约定格式(方法内部的实现无所谓):
private void readObject(ObjectInputStream in)
throws IOException, ClassNotFoundException则在反序列化的时候,java.io.ObjectInputStream 这个 Java 类库会通过反射机制调用该方法。
而且,如果存在父类、爷类……,则会从最上层(辈分最大)的可序列化类往下依次调用。
针对序列化的 writeObject 也是同理,这里不再赘述。
其他值得注意的点#
| 注意点 | 描述 |
|---|---|
Serializable | 类本身实现或从父类继承了该接口才能序列化;所有非 transient、非 static 字段的值也必须可序列化,否则抛 NotSerializableException。 |
| 访问修饰符 | 可序列化类中的字段不论 public/protected/private/final,都会被序列化和还原。JDK 通过反射发现字段,通过 Unsafe 读写字段值。 |
transient 和 static | 默认机制不会序列化它们;transient 字段可在自定义 writeObject/readObject 中手动处理。 |
serialVersionUID | 反序列化时比较字节流与当前类的版本号,不一致抛 InvalidClassException;未声明时由 JVM 根据类结构计算,类一改就会变,建议手动声明。 |
如何构造利用链?#
Gadget:应用或者依赖库中的某段代码片段
Gadget Chain(利用链):将各个 Gadget 串联,组成一条链。
Gadget Chain 的核心特性:以反序列化操作为触发器,能自动地走完链上的所有 Gadget。
So,如何构造利用链?
没有什么特殊的技巧,只需要记住:Gadget 是载体,自动化是精髓,反序列化是触发器。